Caractere de evitat în numele fișierelor și directoarelor
Numele fișierelor influențează URL-urile, compatibilitatea între sisteme și eficiența muncii. Un mic detaliu care previne multe probleme.
Citește articolulAproape toți folosim combinația Ctrl + F (sau Cmd + F pe Mac) pentru a găsi rapid un cuvânt într-un document sau pe o pagină web. E simplu, rapid și familiar. Problema este că, în…
Aproape toți folosim combinația Ctrl + F (sau Cmd + F pe Mac) pentru a găsi rapid un cuvânt într-un document sau pe o pagină web. E simplu, rapid și familiar. Problema este că, în momentul în care lucrezi cu mii de documente, baze de date, log-uri sau cod sursă complex, Ctrl + F devine insuficient.
În era datelor masive, avem nevoie de ceva mult mai deștept: motoare de căutare avansată precum dtSearch, unelte concurente și expresii regulate (regex). Acestea nu doar găsesc un cuvânt, ci pot identifica modele în text, pot căuta în zeci de tipuri de fișiere și pot lucra la scară de terabytes.
„Ctrl + F” funcționează acceptabil atunci când:
Dar lista de limitări este mult mai lungă:
Dacă ar fi să facem o comparație, Ctrl + F este ca o lanternă mică: te ajută în camera ta, dar nu vei ilumina niciodată o clădire întreagă cu ea.
dtSearch este unul dintre cele mai cunoscute motoare de căutare pentru medii enterprise, folosit intens în:
("fraudă" OR "evaziune") AND "raport financiar" w/10 "Q4"
Adică găsește documente unde „fraudă” sau „evaziune” apar la maximum 10 cuvinte distanță de „raport financiar” și „Q4”.Practic, dtSearch îți oferă o perspectivă de ansamblu asupra întregului tău univers de fișiere, nu doar asupra unui document deschis în fața ta.
Expresiile regulate (regex) sunt un limbaj pentru a descrie modele în text. Combinarea regex cu un motor de căutare avansat (dtSearch, Elasticsearch, grep/RipGrep etc.) îți dă o putere pe care Ctrl + F nu o va avea niciodată.
Email-uri:
[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}
Date (format MM/DD/YYYY):
(0[1-9]|1[0-2])/(0[1-9]|[12][0-9]|3[01])/\d{4}
Mesaje de eroare în log-uri:
ERROR\s+\d{3}:\s+.*
Uneltele moderne de căutare precum dtSearch, Elasticsearch sau RipGrep pot rula astfel de regex-uri peste mii sau milioane de fișiere, economisind ore sau chiar zile de muncă manuală.
dtSearch nu este singurul jucător din piață. În funcție de nevoi, poți combina sau alege și alte soluții:
Elasticsearch este un motor de căutare și analiză distribuit, ideal pentru:
X1 Search este orientat puternic spre:
Copernic Desktop Search este o soluție mai ușoară, bună pentru:
RipGrep și utilitarul clasic grep sunt extrem de populare în rândul dezvoltatorilor, datorită:
Fiecare unealtă are punctele ei forte, dar toate au un lucru în comun: depășesc cu mult funcționalitatea simplă a lui Ctrl + F.
Când găsești informația corectă în câteva secunde, nu în câteva ore, deciziile se iau mai repede, iar proiectele se mișcă mai fluid.
Căutarea avansată (dtSearch, regex, Elasticsearch) reduce erorile umane – nu mai „sari peste” documente relevante doar pentru că nu ai intuit cuvântul exact.
În domeniul juridic, financiar sau medical, găsirea rapidă și completă a informației poate însemna diferența între conformitate și sancțiuni. Motoarele de căutare enterprise sunt indispensabile în aceste scenarii.
Analiza log-urilor cu regex și motoare de căutare permite detectarea unor pattern-uri suspecte, a erorilor recurente sau a intruziunilor.
Organizațiile care pot căuta eficient în propriile resurse devin mai agile, își reduc dublarea muncii și cresc valoarea cunoașterii interne.
Dacă lucrezi cu:
atunci Ctrl + F nu mai este suficient. Ai nevoie de unelte precum dtSearch, de motoare precum Elasticsearch, de soluții desktop puternice (X1, Copernic) și de regex ca limbaj de descriere a pattern-urilor.
Trecerea de la căutarea simplă la căutarea avansată nu este doar un upgrade tehnic; este un pas strategic pentru oricine vrea să exploateze la maximum valoarea datelor pe care le deține.
Toate aceste concepte – dtSearch, regex, motoare de căutare enterprise – sunt extrem de puternice, dar și suficient de tehnice încât să devină descurajante pentru cineva care vrea doar rezultate rapide și corecte, nu încă un „skill” complicat de învățat. De aceea, în loc să petreci zeci de ore să aprofundezi sintaxe, opțiuni avansate și scenarii de edge case, este mult mai eficient să lucrezi cu o echipă care stăpânește deja aceste unelte și le folosește zilnic în proiecte reale.
Noi ne ocupăm de partea complexă – proiectarea indexării, definirea pattern-urilor regex, alegerea motorului de căutare potrivit, optimizarea performanței – iar tu te bucuri direct de performanță, precizie și timp câștigat. Practic, în loc să îți încarci agenda cu încă un „limbaj” de învățat, lucrezi cu noi și obții aceleași beneficii (sau chiar mai mari) într-un mod mult mai simplu, predictibil și scalabil pentru afacerea ta.
Primul pas este evaluarea arhivei: un raport clar despre ce aveți, ce se poate procesa, în cât timp și cu ce riscuri.
Solicită evaluarea arhivei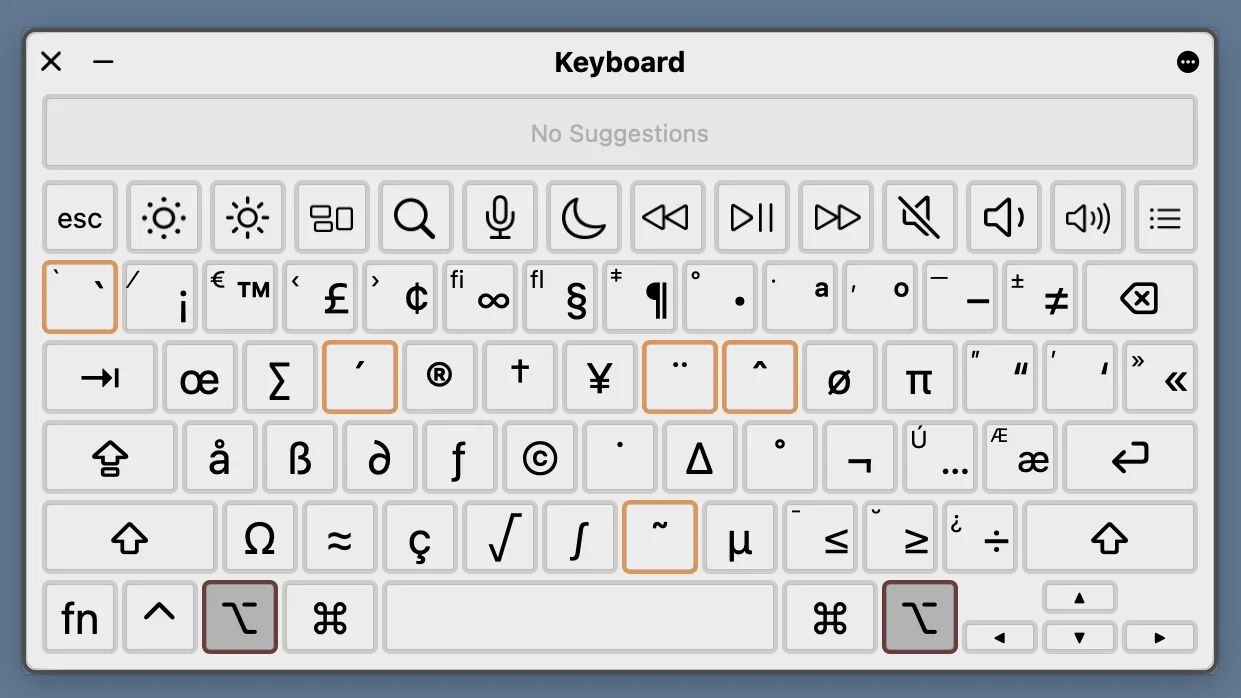
Numele fișierelor influențează URL-urile, compatibilitatea între sisteme și eficiența muncii. Un mic detaliu care previne multe probleme.
Citește articolul
Într-o lume legală tot mai digitalizată, cabinetele de avocatură se confruntă cu volume tot mai mari de documente. Procesarea inteligentă a acestora – cu ajutorul OCR, AI și…
Citește articolul
Pe măsură ce organizațiile continuă să avanseze spre transformarea digitală, o întrebare apare în mod constant: Este o arhivă de documente digitală mai bună decât o arhivă fizică,…
Citește articolul